2026最新指南:如何用AI做出爆款视频(保姆级教程)
零基础也能跟着做的AI视频教程:文生视频、图生视频、参考生视频、多镜头叙事、讲好故事、声音剪辑、爆款选题与变现、避坑指南。文中每条视频都是真实生成的,提示词原样附上。
AI 视频生成已经成熟到:任何人花几分钟,就能做出一条像样的短片。
这篇指南会带你走完全程:从生成第一条视频,到讲好一个故事,再到选题和变现。
读完收获: 3 分钟生成你的第一条 AI 视频,并搞懂爆款视频背后的逻辑。
适合谁读: 零基础,想用 AI 快速上手短视频创作的人。
本文摘要: 文生视频、图生视频、参考生视频、多镜头叙事、故事结构、声音与剪辑、选题与变现、避坑指南。文中所有视频都是在 Kensa 上真实生成的,提示词原样附上,可以直接复制去试。
文 / Kensa 内容团队
序言:做视频的门槛,已经塌了
以前,拍一条 10 秒的短片,要演员、要场地、要设备,还要花大量时间剪辑。
现在,你需要的只是:一句话,或者一张照片。
剩下的事,交给 AI。
说门槛已经塌了,一点都不夸张。真正拉开差距的,不再是设备和预算,而是你会不会「说清楚你想要什么」,以及你有没有一个好故事。
这篇文章,就是教你这两件事。
一、第一式:文生视频
很多人觉得,做 AI 视频很难。
其实不是。
打开 Kensa 的文生视频,找到那个最大的输入框,输入:
一只柯基在海边奔跑
模型选 MiniMax H3(Kensa 的默认模型),点生成,等一两分钟,你会得到这样一条视频:
很神奇吧?
你只打了几个字,AI 就给了你一条有画面、有声音的视频。放在几年前,这就是魔法。
现在,我们弄清楚刚才发生了什么:
- 你输入的那句话,叫 提示词(prompt),它告诉 AI 你想要什么;
- 输入文字、得到视频,这个过程叫 文生视频。
1.1 好提示词的公式
说实话,刚才那句提示词写得太随意了。
随意的提示词,结果也很随机:狗是什么品种、海边是什么时间、镜头从哪拍,全靠 AI 自己猜。
想要稳定、好看的效果,按这个结构写:
主体 + 动作 + 场景 + 光线 + 镜头 + 画面风格
对比一下:
❌ 随意版
一只柯基在海边奔跑
✅ 讲究版
一只橘白相间的柯基在清晨的海滩上全速奔跑,
耳朵被风吹向后方,爪子踩起细小的浪花和沙粒。
金色逆光,海面闪着碎光,低机位跟拍镜头,浅景深,电影级画质。
讲究版好在哪?看这张表:
| 要素 | 讲究版里的写法 | 解决了什么 |
|---|---|---|
| 主体 | 「橘白相间的柯基」 | 品种、毛色不用猜 |
| 动作 | 「全速奔跑,耳朵被风吹向后方」 | 速度感和细节有了 |
| 场景 | 「清晨的海滩」 | 时间、地点锁定 |
| 光线 | 「金色逆光,海面闪着碎光」 | 氛围可控 |
| 镜头 | 「低机位跟拍,浅景深」 | 镜头语言确定 |
| 风格 | 「电影级画质」 | 整体质感拉高 |
同一个模型,换成讲究版提示词,生成的效果是这样:
是不是像样多了?逆光、浪花、跟拍,全是你在提示词里点过名的东西。
一个小技巧: 每次只改一个要素。比如这次只改光线,下次只改镜头。这样你很快就能摸清:哪个词在起作用。
1.2 文生视频的长处与短板
长处很明显:脑子里想到什么,写成文字就能变成视频,最快、最省事。
短板也有:
- 同一句提示词,每次生成的结果都不一样;
- 角色的长相、画面的构图,没办法锁定。
如果你只是做一条好玩的视频,这无所谓。但如果你要做系列内容、做品牌、做短剧,需要「每一集里的主角都是同一个人(同一只狗)」,文生视频就不够用了。
二、第二式:图生视频
为了解决「锁不住画面」的问题,有一个很直接的办法:先给 AI 一张图。
你给 AI 文字的同时,再给它一张照片。AI 就不用自己猜画面长什么样了,它只需要让这张照片动起来。
这就是 图生视频。
比如,我准备了这样一张比格犬的照片:
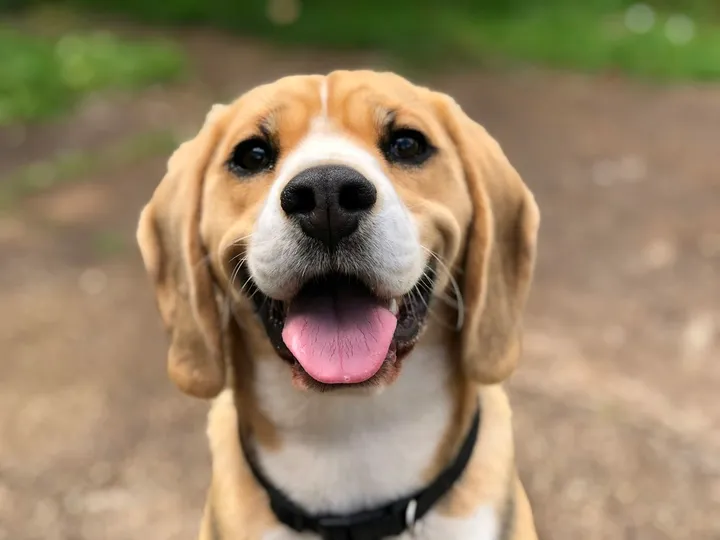
在 Kensa 的图生视频 里上传它,模型选 Veo 3.1,提示词写:
这只比格犬在公园的小路上欢快地奔跑,耳朵上下甩动,
低机位跟拍镜头,自然光。
一两分钟后,得到这条视频:
还是照片里那只狗,连项圈都没变。
2.1 图生视频的长处与短板
长处:最终的视频和你给的照片高度一致。先有图,就大概知道视频会长什么样,返工少、浪费少。这对做产品视频、做品牌内容的人来说,意义很大。
短板:
- 你得提前准备好这张图;
- 画面被照片「框」住了,灵活度低。照片里是公园,视频基本就在公园。
顺便说一句: 如果你不想自己琢磨提示词,可以直接用 Kensa 的视频模板。它就是图生视频的「套餐版」:上传一张产品或宠物照片,模型、时长、画幅和提示词都已经配好,一键套用。
三、第三式:参考生视频
图生视频太「死板」,文生视频又太「随机」。有没有折中的办法?
有,叫 参考生视频。
它和图生视频的区别,看这张表:
| 对比项 | 图生视频 | 参考生视频 |
|---|---|---|
| 输入 | 一张完整的画面 | 一张或多张参考图,只当「素材」用 |
| 画面控制 | 几乎照搬照片 | 保留你指定的角色,其余由 AI 补全 |
| 自由度 | 低 | 高 |
| 适合 | 产品展示、单个主体动起来 | 多角色剧情、场景经常变的内容 |
一句话:参考生视频,能同时拿到「可控」和「自由」。
举个例子。我准备了两张照片:一只穿毛衣、总是一脸不高兴的黑色巴哥,和一只永远在笑的比格犬。
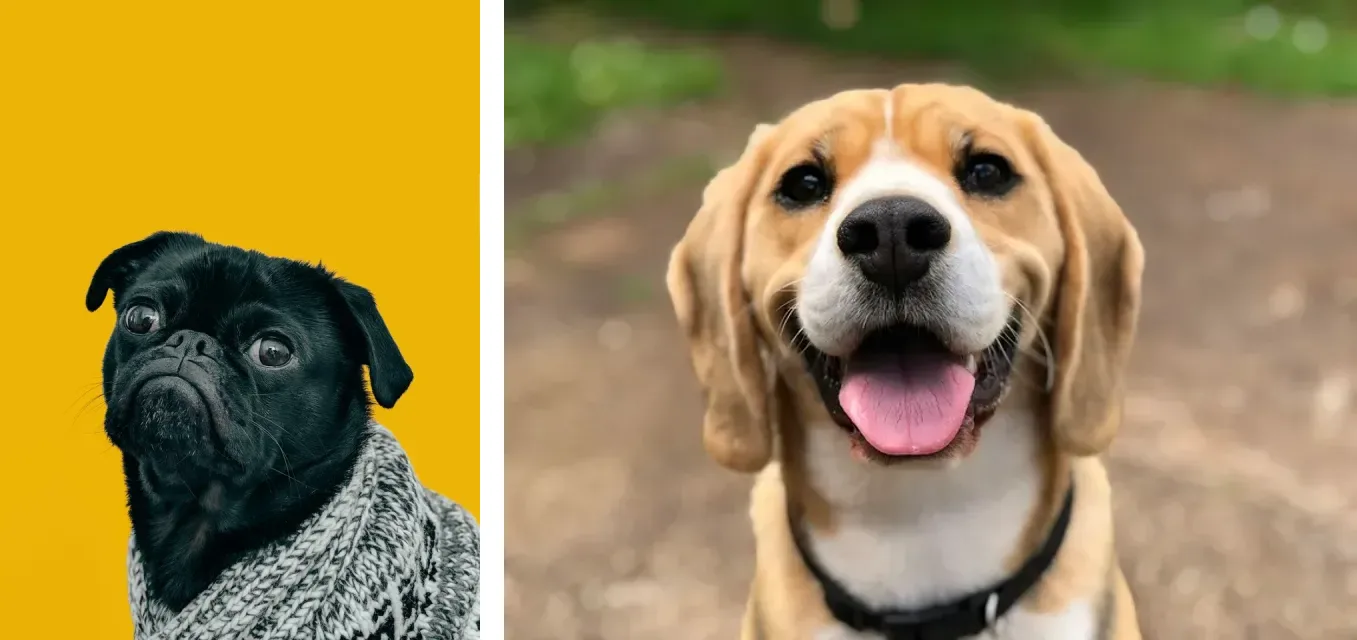
把这两张图上传到 Kensa 的参考生视频,模型选 Seedance 2.0,提示词写:
图1里的黑色巴哥犬和图2里的比格犬,在温馨的客厅地毯上抢同一个黄色毛绒玩具,
巴哥一脸不情愿,比格犬兴奋地摇尾巴。
中景,自然光,生活感。
生成的视频是这样:
同样两张图,只把场景换掉:
图1里的黑色巴哥犬和图2里的比格犬,在洒满阳光的公园草地上并排散步,
比格犬蹦蹦跳跳,巴哥慢吞吞地跟在后面。
中景,跟拍镜头,自然光。
对比这两条视频,你会发现:
- 场景完全不一样:一个在客厅,一个在公园;
- 客厅和公园都不是我给的,是 AI 自己补出来的;
- 两只狗的样子没变:巴哥还穿着那件毛衣,比格犬还戴着那个项圈。
我们想保持不变的(角色),保持住了;我们想变的(场景),轻松变了。这就是「可控」和「自由」之间的平衡。
注意: 参考图请用宠物、产品、插画或 3D 角色。真人、名人、儿童的照片,模型方会直接拒绝。
四、第四式:多镜头叙事
有了前三式,你其实已经能做视频了。
但如果你想讲一个有来有回的小故事,一个镜头一个镜头地生成,效率太低:每个镜头都要重新上传图片、重新写提示词。
于是有了 多镜头:让 AI 在一条视频里,一次生成好几个镜头,并自动衔接起来。
还是那两只狗,提示词这样写:
图1里的黑色巴哥犬和图2里的比格犬在客厅里。
[镜头1] 0-3秒,近景,巴哥犬皱着眉头,对着镜头不满地哼了一声。
[镜头2] 3-6秒,近景,比格犬歪着头,开心地吐舌头,尾巴摇个不停。
生成的视频:
看到了吗?第 3 秒左右,镜头从巴哥的近景,切到了比格犬的近景。一条视频里有了两个镜头,还有了「一个生气、一个开心」的反差。
写多镜头提示词的要点:
- 先交代角色和场景,再分镜头写;
- 每个镜头写清楚:时间段、景别(近景 / 中景 / 远景)、谁在做什么;
- 相邻两个镜头,景别或视角最好不同,切换会更自然;
- 我这里只写了两个镜头,你可以写更多,但单条视频越短,镜头越多,每个镜头就越赶。
五、第五式:讲好故事
学到这里,你已经能做出小短片了。恭喜你,基本功已经到手。
这一节,我们聊最核心的东西。
为什么有的视频,你会一口气看完、还想转发;有的视频,你两秒就划走了?
答案有很多:画面好、声音好、角色可爱……但几乎所有能被记住的作品,都有一个共同点:有故事。
既然你已经会做视频了,就别浪费这个本事。用它讲故事,你的作品才有机会火。
5.1 故事的骨架:三幕式
如果你只做一条几秒的短片,想到哪做到哪,完全没问题。
如果你要做稍长一点的内容,就得先搭骨架,就像盖房子要先有图纸。
最经典的结构是 三幕式:
- 第一幕:开端。 交代主角是谁、日常是什么样。
- 第二幕:冲突。 出事了。主角遇到麻烦,一波接一波。
- 第三幕:结局。 主角解决麻烦(或者没解决),故事落地,观众得到满足。
5.2 短视频版:15–60 秒的 5 拍结构
短视频没有时间慢慢铺垫。我们把三幕式压缩成 5 拍,专门给 15–60 秒的视频用:
| 拍子 | 大概时长 | 作用 | 用巴哥和比格犬举例 |
|---|---|---|---|
| 1. 钩子 | 前 3 秒 | 一个让人停下来的画面或问题 | 巴哥一脸生无可恋地瞪着镜头 |
| 2. 反差 | 3–8 秒 | 抛出冲突或对比 | 镜头一转,比格犬叼走了巴哥的玩具 |
| 3. 升级 | 8–20 秒 | 冲突加码,观众开始期待结果 | 巴哥追,比格犬以为在玩,越跑越欢 |
| 4. 反转 | 20–30 秒 | 出乎意料的结果 | 比格犬把玩具放回巴哥面前,还舔了它一下 |
| 5. 收尾 | 最后几秒 | 回扣开头,给情绪落点 | 巴哥还是那张臭脸,但尾巴悄悄摇了起来 |
新手提示: 先把这 5 拍写在纸上,每一拍对应一到两个镜头,再按第四式的写法逐个生成。
等你熟练了,可以去读编剧布莱克·斯奈德的《救猫咪》,他的 15 个节拍更细,是很多商业片编剧的工具书。不过那是为 90 分钟的电影设计的,用在短视频上要大幅压缩,别生搬硬套。
六、第六式:声音与剪辑
有了故事,有了一堆镜头,最后一步就是把它们拼起来。
拼接 相对简单:按你写好的 5 拍顺序,把镜头首尾相连就行。手机上的剪映、CapCut,电脑上的任何剪辑软件都可以。
真正拉开差距的,是 声音。
脚步声、风声、雨声、玩具被叼起时的「吱」一声、狗的哼哼声……这些细节一加,作品立刻上一个档次。
好消息是:本文用到的 MiniMax H3、Veo 3.1、Seedance 2.0,生成的视频本身就带声音。上面的示例视频,打开声音就能听到。
一个实用建议: 如果你要把多个镜头拼成一条完整的片子,最后通常要统一配一段背景音乐。这时候,生成单个镜头时最好只要环境音和音效。可以在提示词末尾加一句「只要环境音和音效,不要背景音乐」。不同模型对这句话的执行程度不一样,不满意就多生成一次。
七、第七式:爆款选题与变现
到这里,你已经能完整做出一部作品了。
离爆款,只差最后一步:选题。
同样的制作水平,选题不同,结果天差地别。想做爆款,从选题这一步就要想清楚。
7.1 经久不衰的爆款原型
翻一翻电影史和短视频平台,最受欢迎的故事,内核总在重复。这些原型被验证了几十年,同样适用于 AI 视频:
原型一:逆袭与反差。 普通人突然变强、突然变富,或者一个反差巨大的身份错位。它满足的是观众对「命运逆转」的渴望。经典电影:《蜘蛛侠》《当幸福来敲门》。
原型二:萌宠拟人。 给猫狗加上人的情绪和台词,就像本文的巴哥和比格犬。宠物不需要翻译,全世界都看得懂,这是最适合 AI 视频新手的题材之一。可以从 宠物跳舞、滑板狗 这类模板开始。
原型三:视觉奇观。 现实里拍不到、拍不起的画面:从街头一路拉远到太空,产品像冰淇淋一样融化,礼盒像气球一样鼓起来。看的就是「哇」的那一秒。试试 地球拉远、融化特效。
原型四:探险与未知。 神秘的遗迹、陌生的星球、深海里的巨物。激发的是好奇心。经典电影:《夺宝奇兵》《侏罗纪公园》。
原型五:节日与情绪。 圣诞、新年、黑五……节日自带流量,观众在这几天本来就想看、想转。可以从 圣诞产品视频、新年视频 这类模板开始。
原型六:好物种草。 一个产品,用最好看的方式展示出来:360 度旋转、开箱、细节特写。这是最直接能卖货的题材,也是商家最愿意花钱的内容。参考 产品视频模板、开箱视频模板。
核心心法: 原型是「心法」,AI 是「招式」。只学招式,容易做出一堆好看但没人记得住的视频;心法练熟了,用 AI 这个新招式,就能把这些经典故事讲给全世界的观众听。
当然,选了这些方向不等于一定会火。它们只是被市场反复验证过、值得借鉴的起点。你还是要有自己的故事,讲出自己的观点。
7.2 变现路径
做 AI 视频,常见的变现方式有这四种:
路径一:平台创作者分成。 TikTok、YouTube、抖音、视频号等平台都有创作者激励或广告分成。门槛最低,适合个人创作者起步。注意:各平台对 AI 生成内容的标注要求和分成规则不一样、变化也快,发布前一定先看平台的最新规定。
路径二:系列内容和 AI 短剧。 固定角色、固定风格,一集一集更新。比如本文的巴哥和比格犬,完全可以做成一个系列。角色立住了,粉丝会追更。参考生视频(第三式)和多镜头(第四式),就是做系列内容的基本功。
路径三:给商家做视频。 电商卖家、本地商家、品牌方,都需要大量的产品视频和广告素材,而且需求一直在。这是最直接、最稳定的现金流。可以先看看 AI 电商视频的做法。
路径四:品牌合作。 当你的账号或角色有了稳定的粉丝,品牌会主动找你做定制内容。这是利润最高的方式,但需要前面三条路的积累。
变现心法: 先用最低成本把作品做出来、发出去,看数据、找方向;跑出一个有反馈的题材,再持续投入。不要一开始就追求大制作。
八、第八式:避坑指南
Q1:为什么提示词写了很多,AI 就是不照做?
A:通常是一句话里塞了太多要求,或者要求互相矛盾(比如「清晨」又写「霓虹灯」)。按第一式的公式重写,一次只改一个要素,找出是哪个词没起作用。
Q2:为什么拼接后的视频,总感觉跳帧?
A:最常见的原因,是用上一个镜头的最后一帧,当下一个镜头的首帧。AI 生成的首帧和你给的图并不完全一样,人眼对这种细微差别很敏感,就会觉得跳。
解决办法:做好分镜,相邻镜头换景别、换视角,甚至换主体。简单说,不要让相邻两个镜头的构图一模一样,跳帧感就会大幅减少。
Q3:同一个角色,前后长得不一样怎么办?
A:每次都用同一张参考图。参考图本身也要处理:画面里只留这一个角色,尽量是正面、清晰、主体占画面大部分,背景越干净越好。
Q4:为什么我上传的照片被拒了?
A:真人照片、名人、儿童,以及带品牌 logo、版权角色的图片,会被模型方的审核拒绝。Kensa 在提交前会先预检,被拦下的请求不扣积分。换成宠物、产品、插画或 3D 角色就可以。
Q5:生成失败了,积分会扣吗?
A:不会。生成失败时,冻结的积分会自动退回。
Q6:AI 生成的视频有版权问题吗?
A:请确保你用的参考图、提示词里提到的角色名、背景音乐等,都不侵犯第三方的权益。不同平台对 AI 内容的规则也不同,发布前请查看各平台的相关规定。
结语:开始你的第一支作品
到这里,你已经掌握了从一句提示词,到讲好故事,再到选题变现的全流程。
现在,放下这篇文章,去做三件事:
- 打开 kensa.cc 注册一个账号(新用户注册送 15 积分);
- 用「主体 + 动作 + 场景 + 光线 + 镜头 + 画面风格」写一句 30 字左右的提示词;
- 生成你的第一条视频。不想写提示词,就直接 套用一个模板。
不要追求完美,先把它做出来。你的第一支作品,就从这几秒开始。
祝你的视频,早日爆火。
相关文章

如何用AI从文本创建视频:2026完整指南
学习如何使用 Sora 2、Veo 3.1 等前沿模型将文本描述转化为精彩的 AI 生成视频。包含分步教程、技巧和最佳实践。

AI视频高级提示词技巧:让你的视频效果翻倍的秘密
深度解析AI视频生成提示词写作技巧。涵盖提示词结构、镜头运动、灯光描述、风格参考、反向提示词及各模型专属技巧,附即用即取的提示词模板库。

AI视频生成踩坑实录:我花$1247测试后的5个血泪教训
3个月实测247条AI视频的真实翻车经历。包括Sora 2生成的蒸汽失败、Veo 3.1的人脸变形、Kling 3的物理Bug。附失败案例截图和避坑指南。